我给 Codex 发了一张截图。图里是个人飞书账号下的「饭团」知识库,我的要求只有一句,把它迁到企业飞书的知识库里。
后面我负责完成个人号和企业号的授权,再确认迁移方案。扫描、试迁移、脚本编写、异常重试和最终验收都由 Codex 接着处理。
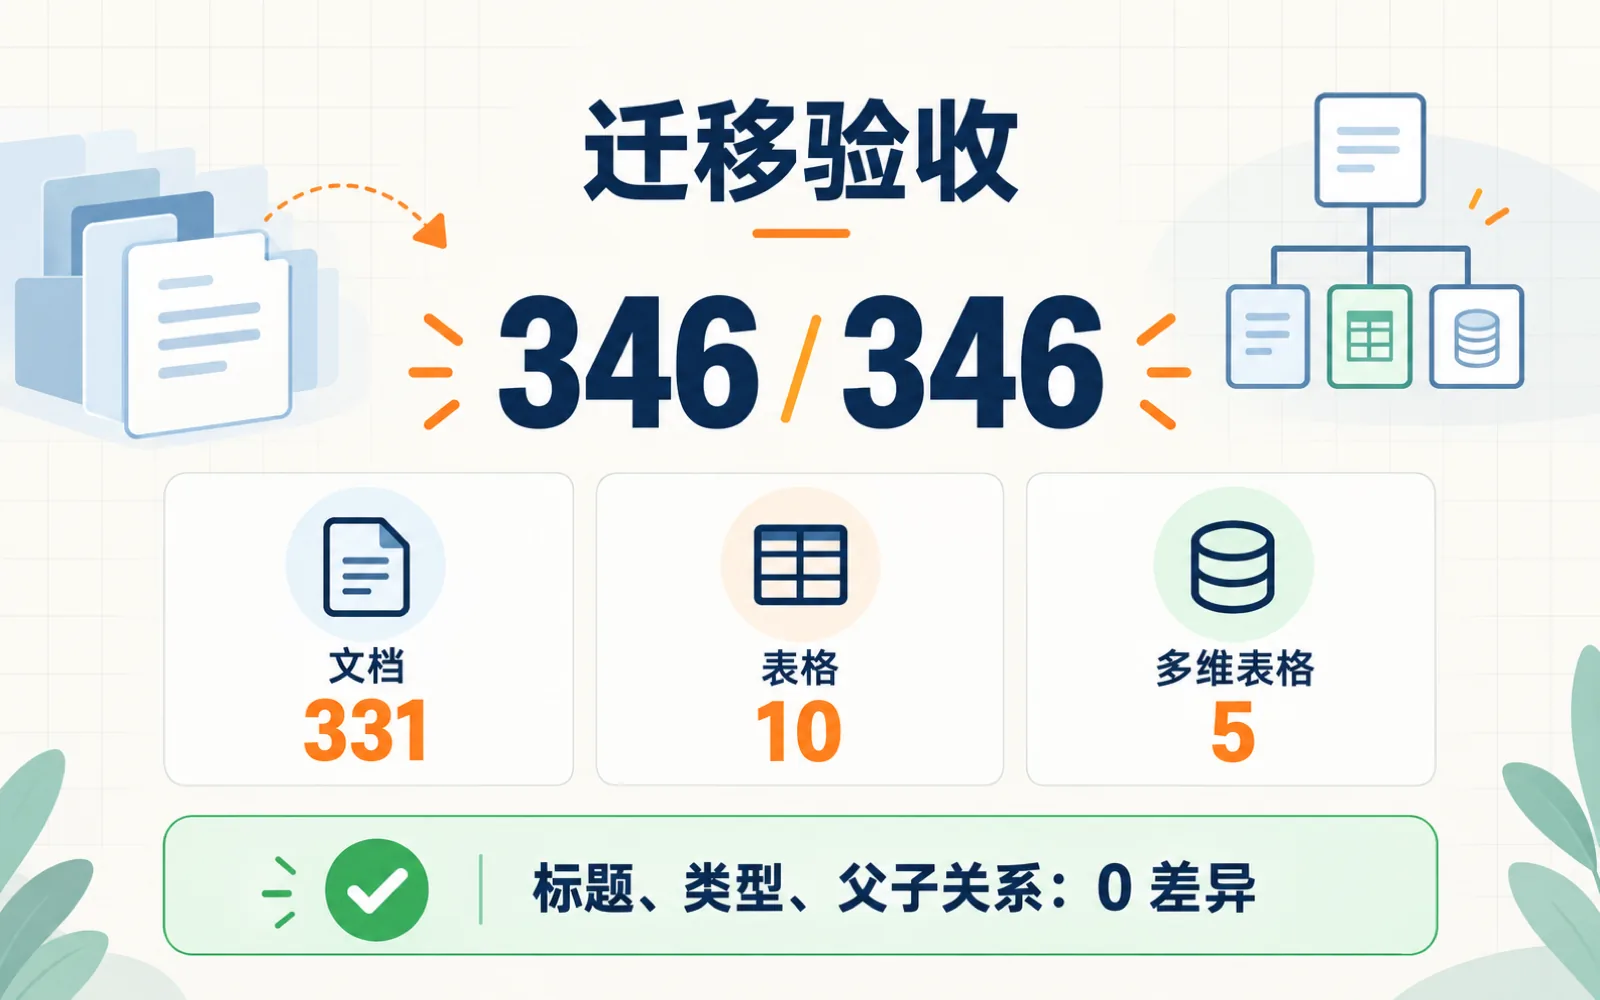
源知识库扫完以后,数量比截图里看到的多得多。一共有 346 个节点,里面有 331 篇文档、10 个电子表格和 5 个多维表格。最深的内容藏在第六层,另外还有 12 篇没有标题的文档。
最后,346 个节点全部进入企业号。企业知识库原来有 10 个节点,迁移后变成 356 个。标题、文件类型和父子层级逐项核对,差异数都是零。
我把 Codex 这次做过的动作和留下的核验结果整理下来。如果你也要做个人飞书和企业飞书之间的迁移,这套方法可以直接借鉴。
直接复制这条路走不通
先卡在权限上。Codex 让我分别授权个人号和企业号,再用两个独立的用户身份读取知识库。个人号能看到源空间,企业号能看到目标空间,可一旦让企业身份读取个人空间,接口就返回权限错误,反过来也一样。
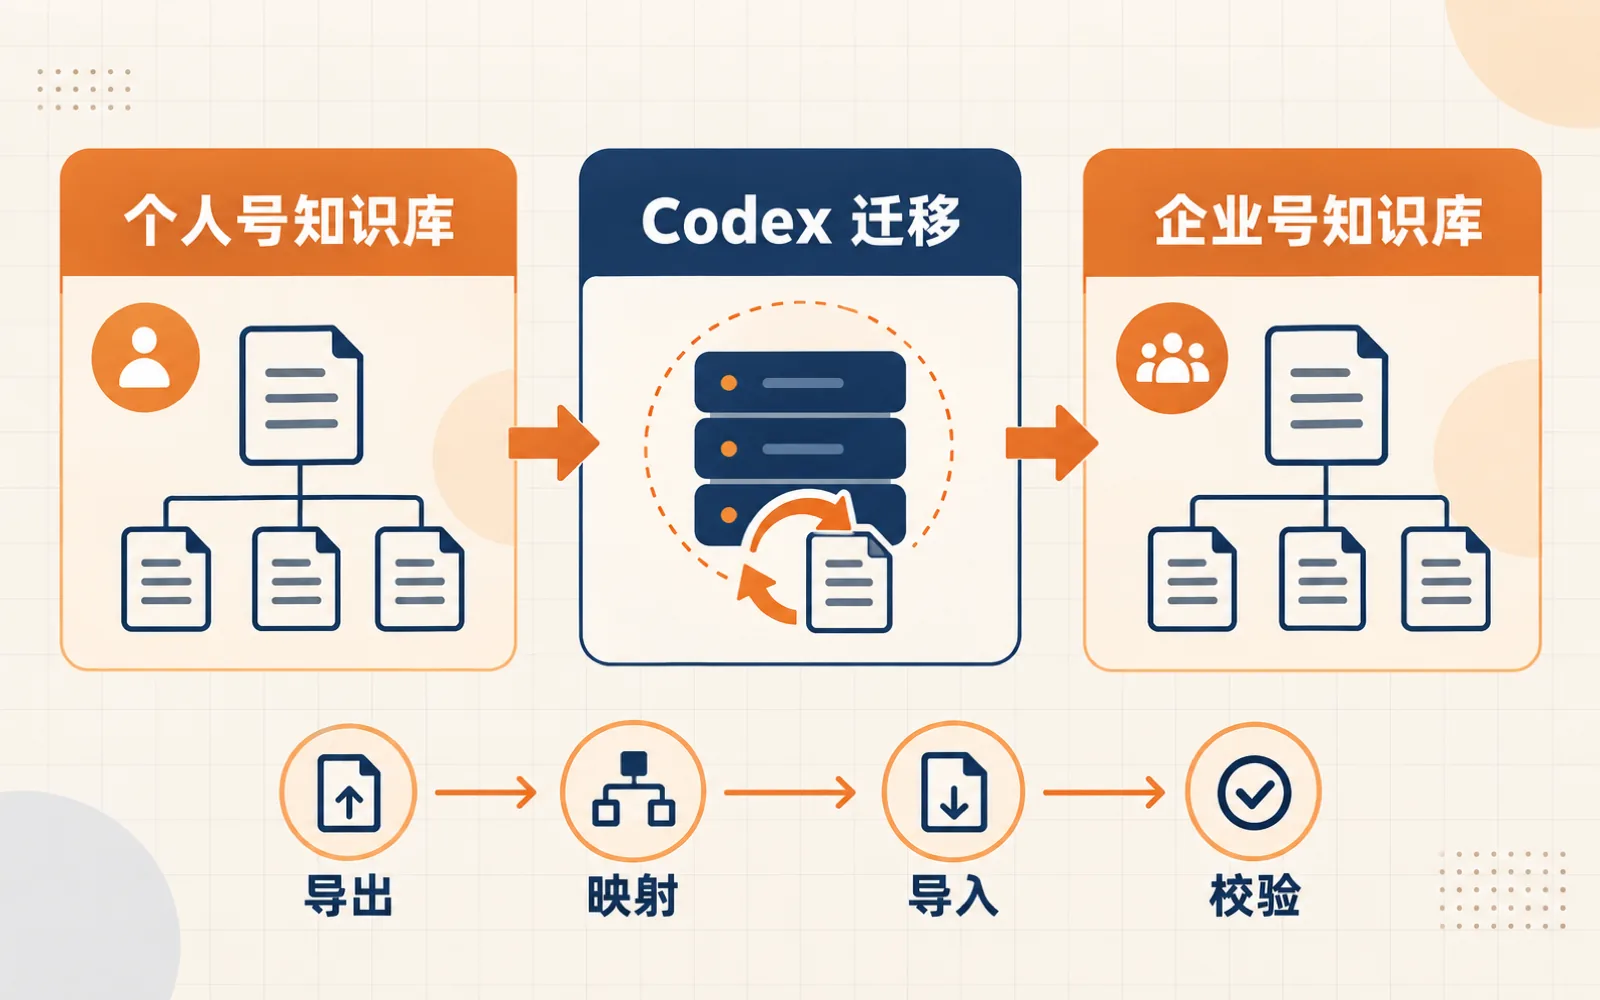
这个限制决定了后面的做法。跨租户时,源节点不能直接复制到目标知识库。迁移必须经过一个中间过程,先把源文件导出来,再用企业身份导入,随后把新文件挂进目标知识库。
飞书知识库里的页面也不能只看页面地址。每个节点至少涉及两个标识。node_token 表示它在知识库目录中的位置,obj_token 指向背后的文档、表格或多维表格。迁移内容要用对象标识,恢复目录要靠节点标识。
先把整棵目录树展开
迁移开始前,Codex 用知识库节点接口从根目录往下遍历。每读到一个带子节点的页面,就把它加入待扫描队列。这个过程采用广度优先,父节点总会排在子节点前面。
清单里为每个节点保存六项信息,包括源节点、源父节点、源对象、对象类型、标题和目录深度。扫完以后,源端的真实规模才确定为 346 个节点。
父节点必须先走。一个子页面导入企业号以后,需要知道自己应该挂到哪个新父节点下面,父页面还没迁完,这个位置就无法确定。广度优先让目录映射按正确顺序产生。
12 个空标题也在扫描阶段被单独标记。导入时,它们会得到类似「未命名文档-FsUXw9vU」的名字。后面的字符串取自源节点标识,既避免重名,也方便追查原始页面。
三种文件走三条转换路径
Codex 没有直接跑全量。它先各选了一份文档、电子表格和多维表格做试迁移。
普通文档先从个人号导出为 DOCX,再用企业号导入为飞书文档。电子表格导出为 XLSX,导入后仍然是飞书电子表格。多维表格使用飞书的 BASE 文件格式,导入后仍然保留多维表格类型。
每个文件导入企业云盘以后,还没有进入知识库目录。程序会调用知识库移动接口,把这个新对象移入目标空间。如果源页面位于根目录,就放在企业知识库根目录。若它有父页面,程序先从映射账本中找到新父节点,再把它挂到对应位置。
试迁移的三份文件全部成功。文档正文能读到,电子表格保留两张子表和数据,多维表格保留原表名及 45 条记录。电子表格中的日期在转换后变成标准日期值,文档的个别文字样式也可能因为 DOCX 转换出现细微变化。这些变化没有影响内容和目录结构。
让迁移可以中断,也能安全接着跑
346 个节点需要连续调用导出、导入和移动接口。麻烦很快就来了。过程中只要遇到一次网络超时,整批从头重跑就会耗掉很多时间,还可能在企业号里制造重复文件。
Codex 为迁移写了两份持久化记录。
第一份是完成账本。每迁完一个节点,就记录源节点、新节点、新对象、文件类型和标题。脚本重新启动时先查这份账本,已经完成的节点直接跳过。
第二份是待处理导入记录。文件成功导入企业云盘以后,程序立刻记下新对象。假如后面的知识库移动失败,下次运行可以接着移动已有对象,无需再次导入。
网络调用带有限次重试。普通网络超时采用逐步延长的等待时间,接口限流则等待更久。实际迁移到第 111 个节点时,一份文档在上传阶段超时。程序留下失败记录并继续处理,重启后根据账本跳过前面已经完成的内容,这份文档随后也补迁成功。
这套账本让迁移具有幂等性。同一个源节点只会对应一个已确认的目标节点,中断、重启和重试都不会改变已经完成的结果。
迁移结束后再查一遍
脚本最后显示 346 个节点完成。Codex 又用企业号身份重新遍历了一遍目标知识库。这次核验不读取迁移过程中的成功提示,只读取企业号里真实存在的目录。
核验分成几步。先数目标空间的节点总量,结果是 356。再检查文件类型,得到 340 篇文档、10 个电子表格和 6 个多维表格。减去企业知识库原有的 9 篇文档和 1 个多维表格,正好等于源端的 346 个节点。
随后逐项比对源目标映射。每个新节点是否存在,背后的对象标识是否一致,类型和标题是否相同,实际父节点是否等于映射后的父节点。五项差异全部为零。12 个空标题也逐个查到了对应的新名称。
源端全程只执行读取和导出,没有删除、改名或移动任何页面。企业知识库原有的 10 个节点也没有被覆盖。
这套方法保留了什么
这次迁移保住了正文内容、表格数据、文件类型、页面标题和完整目录层级。它也留下了源节点到目标节点的映射,后续排查某一页时,可以直接找到两边的对应关系。
历史版本、原评论和原协作者权限不会跟着文件导出。这些信息属于原租户里的协作记录,DOCX、XLSX 和 BASE 文件都无法携带。复杂文档经过格式转换后,也可能出现少量样式差异。迁移前应该先接受这条边界,再决定是否需要人工抽查重点页面。
如果知识库很小,手工复制也许更省事。节点达到几百个,还有多层目录和多种文件类型时,目录清单、父子映射、可续跑账本和独立验收就很有用了。它们把一次容易失控的搬运,变成了一件能够暂停、追查和核对的工程任务。