CI 失败先找准是哪一次运行。把仓库、分支、提交 SHA、工作流名称、失败任务和失败步骤交给 Codex。只复制最后一行报错,常会丢掉真正有用的安装版本、前置警告和执行命令。
沿着运行记录向上看
GitHub Actions 为每次工作流运行保存任务与步骤日志。网页可以打开运行详情,GitHub CLI 也能用 gh run list 找近期运行,再用 gh run view RUN_ID --verbose 看步骤,或用 gh run view --job JOB_ID --log 读取完整任务日志。
先判断失败发生在触发条件、依赖安装、编译、测试、产物上传还是部署。任务意外跳过时,GitHub 官方建议查看日志归档里的条件表达式求值结果。普通日志不足时再开启调试或工具的 verbose 输出,避免一开始就被大量噪声淹没。
把远端环境带回本地
读取工作流文件,核对操作系统、运行时版本、包管理器、缓存键、环境变量名称和执行目录。用工作流里的原命令本地复现,锁文件安装也要保持一致。错误只在 CI 出现时,优先比较大小写敏感路径、时区、并发、权限和缺失服务,不要靠重复重跑掩盖不稳定测试。
让 Codex先解释第一处失败怎样传到后续步骤,再改最小范围。依赖下载失败、测试断言失败和密钥缺失需要完全不同的处理。不要为了变绿而删除断言、扩大超时或把失败步骤设成允许失败,除非仓库明确把它定义为非阻断检查。
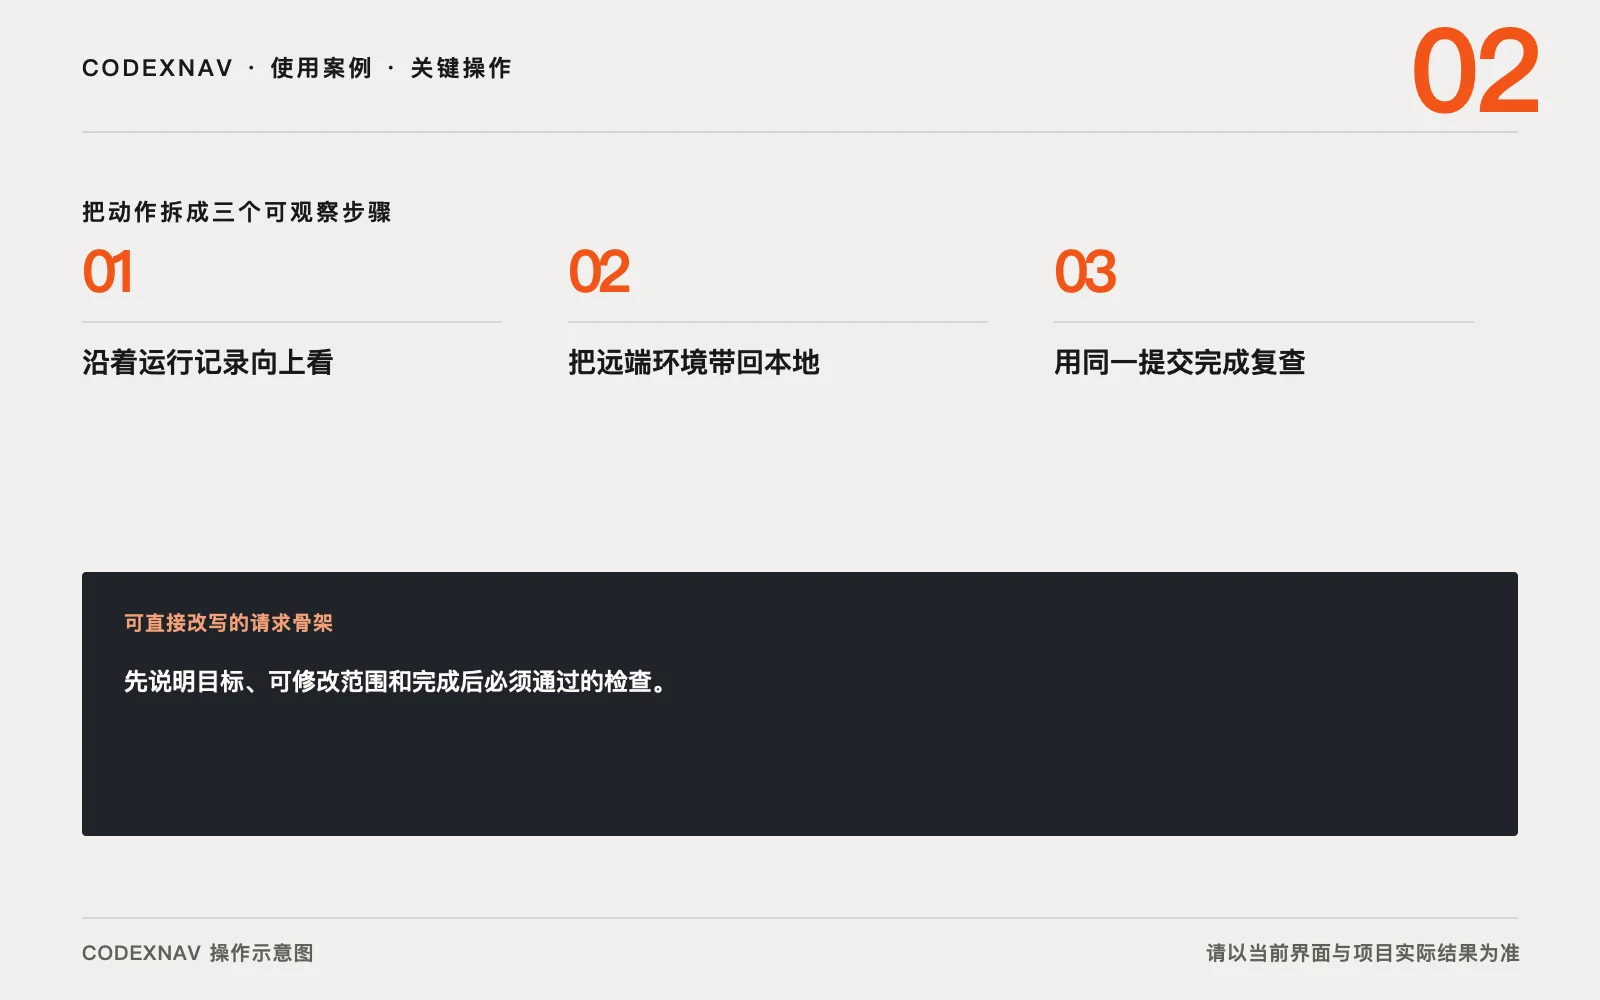
用同一提交完成复查
修复后先运行失败步骤的本地等价命令,再跑相邻检查和完整测试。推送到原分支以后,确认新的工作流运行对应最新提交 SHA。GitHub 的必需状态检查只有达到成功、跳过或中立状态才允许受保护分支继续合并,具体规则由仓库管理员配置。
Codex 可以用 /review 检查当前分支相对基础分支的差异。审查重点放在修复是否解释原日志、工作流配置是否仍保持最小权限,以及新增测试能否稳定复现旧故障。
区分确定失败和偶发失败
同一提交在相同环境每次都停在同一断言,先查代码与固定配置。失败位置漂移,或重跑后自己恢复,就检查共享端口、测试顺序、随机种子、并发写入和外部服务。把失败测试单独运行,再与相邻测试交换顺序,可以快速判断是否存在状态泄漏。
缓存也是常见变量。先看工作流实际命中的缓存键和恢复记录,再做一次不使用缓存的对照运行。无缓存运行通过,只能说明缓存值得继续查,不能立刻删除所有缓存。依赖锁文件、生成产物和运行时版本仍要逐项比较。
需要输出更多日志时,只记录诊断所需字段。密钥、请求头、用户数据和完整环境变量不能进入 Actions 日志。问题解决后撤掉临时调试输出,防止后续运行持续暴露信息或增加费用。
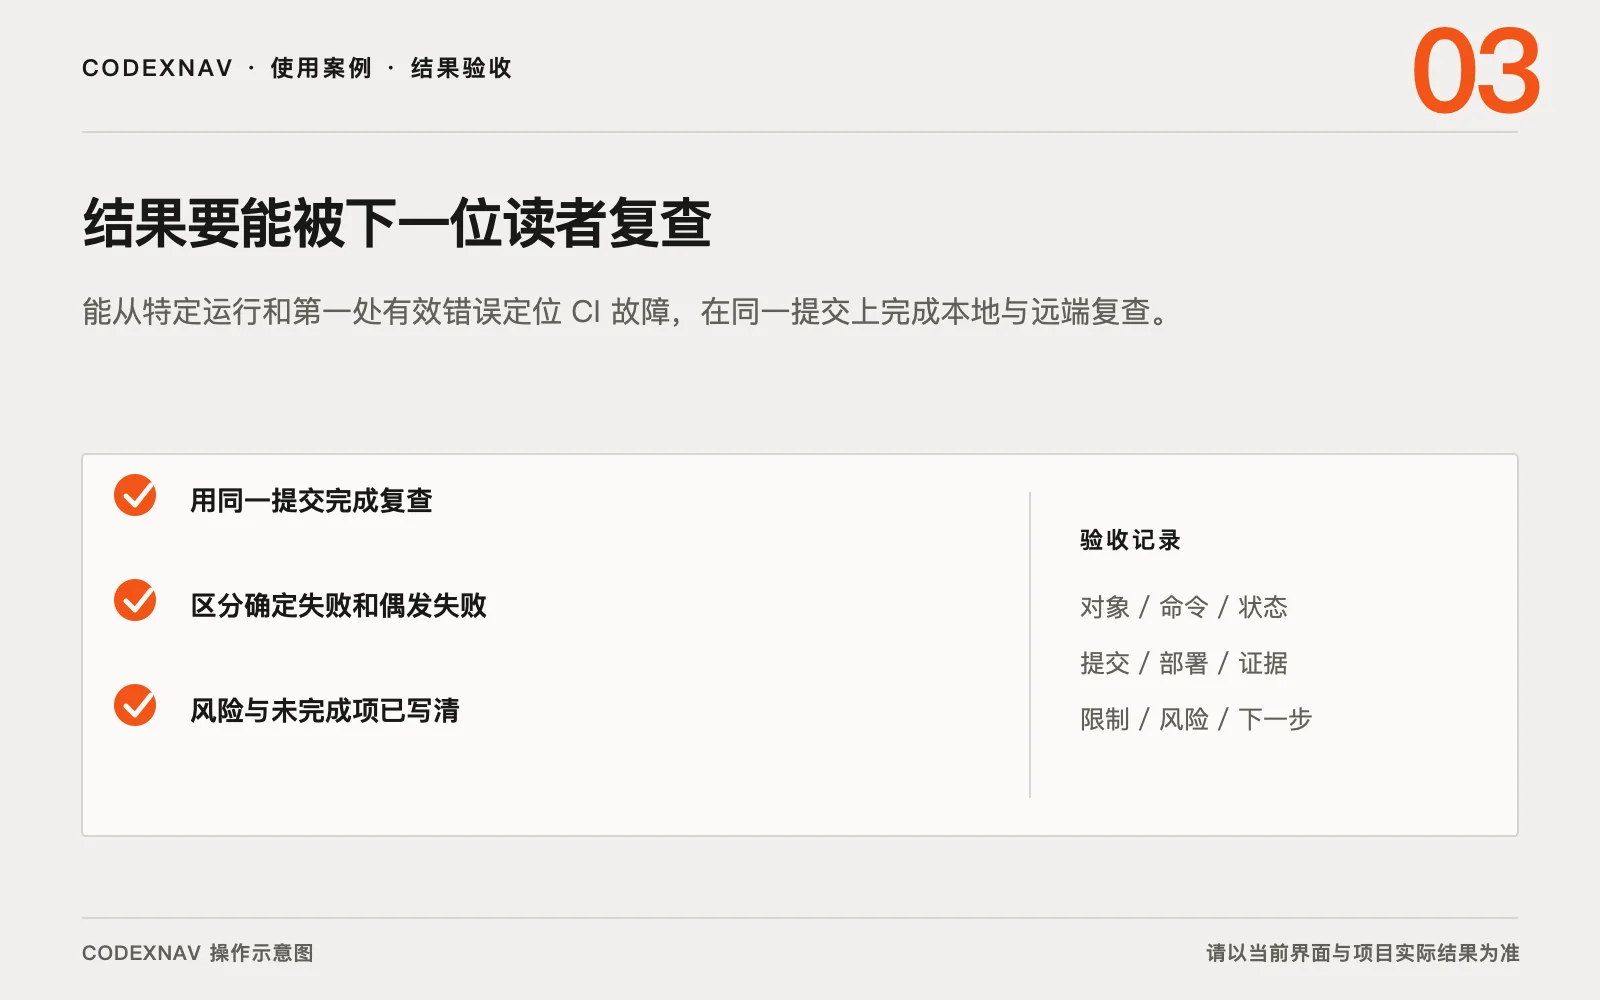
交付记录要保留失败运行链接、根因、修改文件、本地命令和最新 CI 结果。若远端检查仍在运行,就写“已推送,CI 进行中”,不要提前写成完成。