这项任务的最终产物是一份 Promptfoo 配置、一组可审查的用例、连接应用的目标适配器、固定运行命令和首轮基线报告。验收者可以在相同前置条件下重跑命令,看到每个用例的通过或失败原因。生产提示、模型设置和业务行为应等到基线建立后再调整。
先选一项用户承诺
一次只测一件事。从用户能感知的行为中选一个范围。它可以是客服回答要引用检索材料、分类结果必须落在允许标签、工具调用参数符合结构、输出满足业务字段,或代理完成一条明确任务。一次把整个 AI 系统交给 Codex 评测,通常会得到宽泛断言和难以定位的失败。
数据先脱敏。准备用户入口、产品要求、已经发生的缺陷、可公开提交的样例,以及本地服务的启动方式。真实客户数据、密钥和敏感个人信息不能直接放进夹具。需要环境变量时只记录名称与取得方式,评测仓库中保留脱敏且能解释预期的输入。
让 Codex 先检查用户实际经过的应用路径,以及已有测试和评测。优先让 Promptfoo 调用同一端点、函数或代理入口。只测裸模型提示会绕过检索、工具、后处理和业务规则,除非本次目标本来就只关注提示本身。
先跑一条。用手工样例记录请求怎样进入应用、依赖哪些本地服务、输出在哪里取得。这个动作能确认评测目标接得上,也会暴露会话状态、缓存或异步任务等隐藏条件。若同一输入依赖前序对话,就把必要上下文放进夹具,不能让用例碰巧继承开发环境里的旧状态。
先审评测计划再落文件
要求计划写清目标适配器、种子用例、断言、文件位置、运行命令、所需服务和环境变量。每条用例注明它保护哪项承诺。正常输入验证主要路径,边界输入检查空值与模糊请求,受限输入检查拒绝或降级,历史缺陷则直接变成回归案例。
至少放入一条应当通过的简单样例和一条明确应被拒绝的样例。它们能迅速发现适配器把状态码、文本或工具结果读错。评测计划若无法解释这两条为何得到当前结果,应先修接入和断言,再扩充案例。
断言要贴近可观察结果。结构化输出适合校验模式与字段,工具使用适合检查工具名和参数,检索回答适合检查引用与材料一致性。自然语言结果容易出现合理变体,精确全文匹配会产生脆弱失败。可以组合结构规则、关键词边界与人工可读的评分说明。
计划获准后再让 Codex 创建配置、用例目录、适配器和脚本。适配器只负责把 Promptfoo 请求转成应用调用,并返回评测需要的输出与元数据。业务逻辑不要复制进适配器,否则评测可能验证到另一套实现。
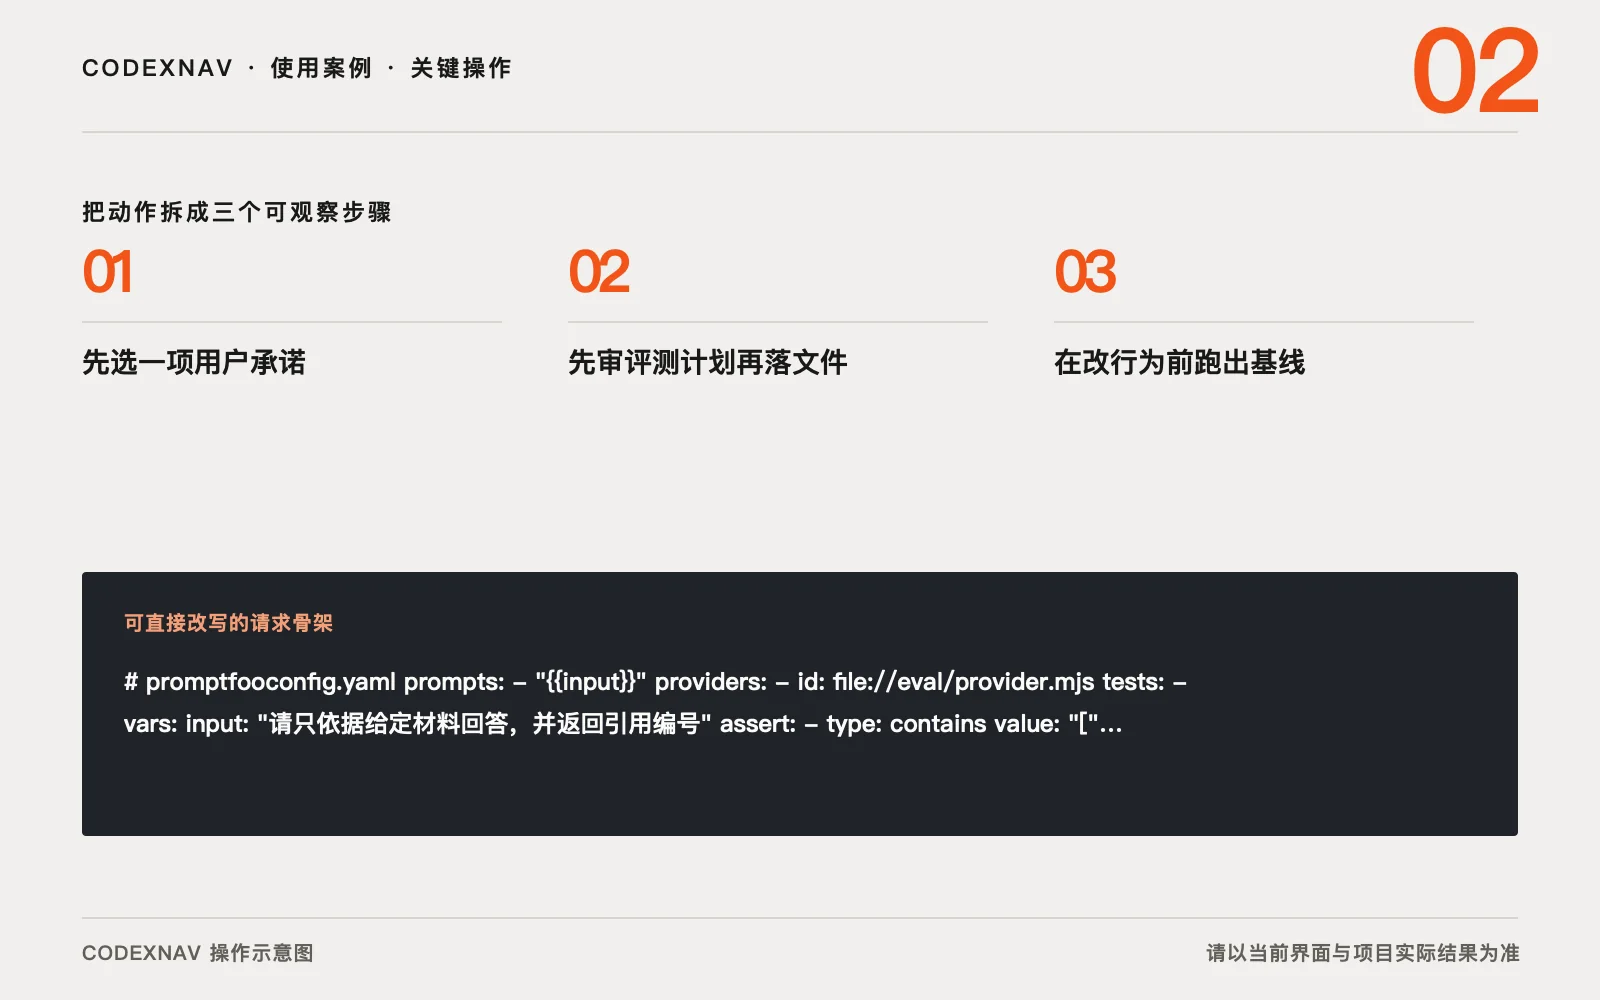
先提交一份能跑一条用例的最小配置。eval/provider.mjs 至少实现 Promptfoo 要求的 id 与 callApi,并在 callApi 中调用用户真实经过的应用入口。下面的配置把一条脱敏输入送给这个适配器,并检查返回结果是否带引用标记。
# promptfooconfig.yaml
prompts:
  - "{{input}}"
providers:
  - id: file://eval/provider.mjs
tests:
  - vars:
      input: "请只依据给定材料回答,并返回引用编号"
    assert:
      - type: contains
        value: "["
先确认 Node.js 满足 Promptfoo 的安装要求;按当前官方安装页,至少需要 Node.js 22.22.0,后续仍应以项目锁定版本的说明为准。把 Promptfoo 作为精确版本的开发依赖写入项目,并提交 package.json 与 lockfile。下面第一条命令会把当时解析到的版本精确写入依赖,后续都调用项目本地版本;同时把 Node.js 与 Promptfoo 版本记进基线报告。
npm install --save-dev --save-exact promptfoo
node --version
npx promptfoo --version
npx promptfoo eval -c promptfooconfig.yaml --output eval/baseline.json
启动应用依赖后运行最后一条命令。终端应显示这条用例的通过或失败,eval/baseline.json 保存本轮原始结果。若请求没有进入应用,先修适配器和环境,再增加更多断言。
在改行为前跑出基线
启动所需本地服务,运行固定命令并保存原始结果。失败要分类。应用在有效用例上违背承诺,属于真实基线缺陷。断言把合理表达判错,需要收紧或放宽评判方式。请求没有到达应用、鉴权错误或响应解析失败,则属于接入问题。
修复接入与明显错误的断言后重新运行,但不要为了全绿而删除真实产品失败。基线报告应列出通过项、失败项、原因分类、运行条件和仍需人工判断的案例。可见结果是一份团队能够接受的当前质量快照,它会成为后续提示、模型或检索改动的比较点。
把评测接进日常改动
当本地命令稳定以后,可以在拉取请求或发布清单中运行。Codex 的非交互模式与 GitHub Action 能把受控任务带入自动流程,具体权限、密钥与沙箱仍要按仓库策略配置。先从耗时可接受、结果稳定的核心用例开始,容易波动或成本较高的集合可以另设人工触发。
每次出现真实缺陷,就增加一个脱敏回归案例。新模型、新提示、新工具或检索策略上线前,用同一套基线比较。新增能力也要增加相应承诺,避免旧集合只证明过去的目标。
风险与限制
评测结果依赖模型、应用版本、数据快照和外部服务。报告必须记录这些条件,单次运行不能支持长期质量结论。全绿也要抽查。评分器本身会出错,高风险案例需要人工复核。评测环境若能触发真实写入或付费工具,应使用沙箱账户、严格权限和可回收资源。
交付清单
- 评测范围对应一项明确的用户承诺
- 种子用例经过脱敏并说明预期
- 目标适配器连接用户实际经过的应用路径
- 配置、断言与运行命令已经提交
- 基线失败按产品、断言和接入原因分类
- 运行条件、外部依赖与人工复核项已经记录