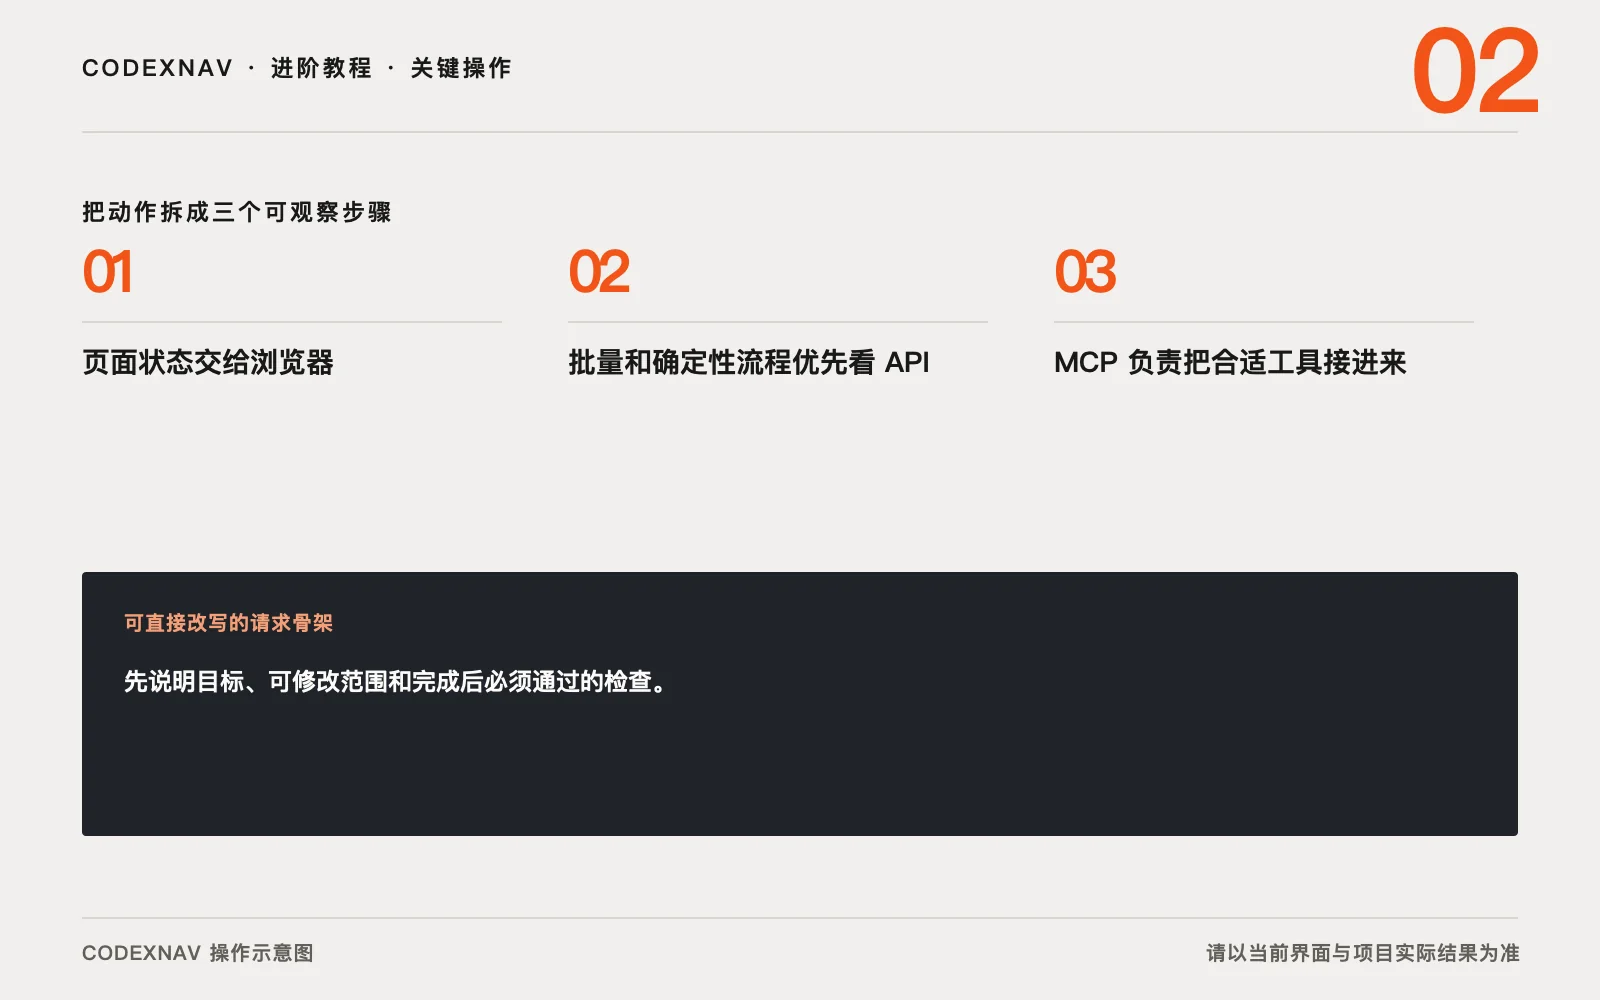
同一个目标常有三条路。浏览器能看见页面并操作界面,API 直接处理结构化数据,MCP 把外部工具与上下文接进 Codex。选择时先问结果落在哪里,以及哪种证据最容易复查。
页面状态交给浏览器
登录、弹窗、拖拽、响应式布局和最终渲染都依赖页面状态,浏览器最合适。ChatGPT Web 与桌面端提供浏览器能力,桌面端内置浏览器使用独立配置文件,不会自动共享常用浏览器的标签和会话。需要现有 Chrome 登录状态时,可以使用 Chrome 扩展,前提是该能力已安装并获准访问目标网站。
浏览器适合截图、复现交互和检查结果。它也会遇到页面改版、会话过期和恶意页面指令。授权前要看清域名,敏感提交、购买、权限变更和删除动作保留人工确认。
批量和确定性流程优先看 API
已有官方 API 时,读取大量记录、按 ID 更新对象、分页同步和重复运行通常更稳定。先读接口文档,确认鉴权范围、分页、速率限制、幂等键和错误码。第一次运行用只读或 dry run,写入时记录请求目标与返回 ID,再查询一次确认结果。
网页能完成的动作未必有公开 API,API 返回成功也未必证明页面最终展示正确。涉及用户可见界面时,可以用 API 完成数据动作,再用浏览器核对渲染状态。
MCP 负责把合适工具接进来
MCP 让 ChatGPT 或 Codex 使用第三方工具与上下文。本地 Codex 客户端支持 STDIO 和 Streamable HTTP,桌面端、CLI 与 IDE 会在同一 Codex 主机上共享 MCP 配置。Web 端通过插件使用托管的远程工具,不读取本地 config.toml。
先检查服务器来源、传输方式和鉴权,再限定允许的工具。只读搜索可以自动执行,写入工具可设为每次提示。令牌从环境变量读取,不能写进项目配置。服务器、插件和工具是否可用,会受客户端版本、ChatGPT 计划、工作区管理员、OAuth 授权和第三方服务权限影响。
用一次预演确认路线
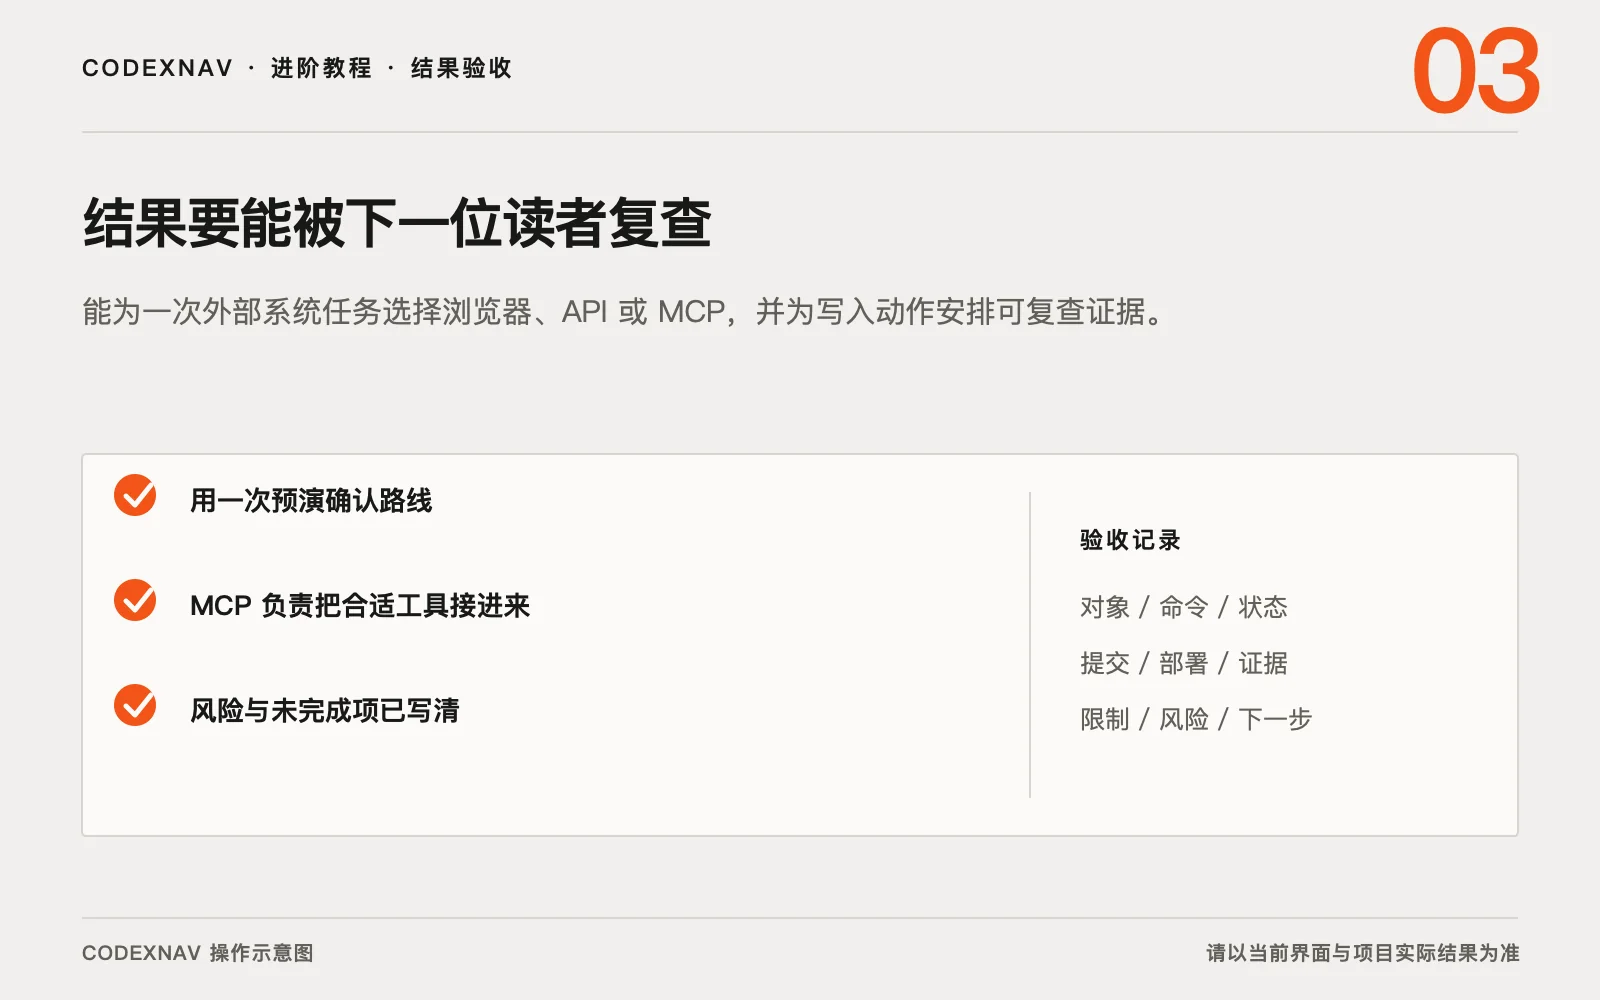
先选一条真实记录做只读预演。浏览器路线记录页面位置和可见结果,API 路线记录端点、对象 ID 与响应,MCP 路线记录服务器、工具名和返回资源。比较哪条路线需要的权限更少,失败信息更清楚,重复执行更安全。
写入动作增加唯一标识和复查步骤。创建记录后再按返回 ID 查询,发送消息后保存目标与时间,修改网页设置后重新打开页面。工具只返回成功字样时,仍要寻找目标系统里的证据。
遇到验证码、人工审批或不可逆操作,就在那一步停下。让自动化准备输入、打开正确位置并说明影响,用户确认后再继续。这样的中断是流程的一部分,不能用更宽权限绕过去。
同一任务若要长期重复,优先保留结构化路径。页面改版会让坐标和文字定位失效,API 或 MCP 工具也可能改 schema。为两种路径都准备版本检查和失败回执。
选择可以混用。浏览器负责可见状态,API 负责稳定数据动作,MCP 负责让 Codex 发现并调用已有能力。关键是把输入、写入范围、失败处理和最终复查写进任务,工具名称随后再定。